AI動画生成における後処理パイプライン完全解説
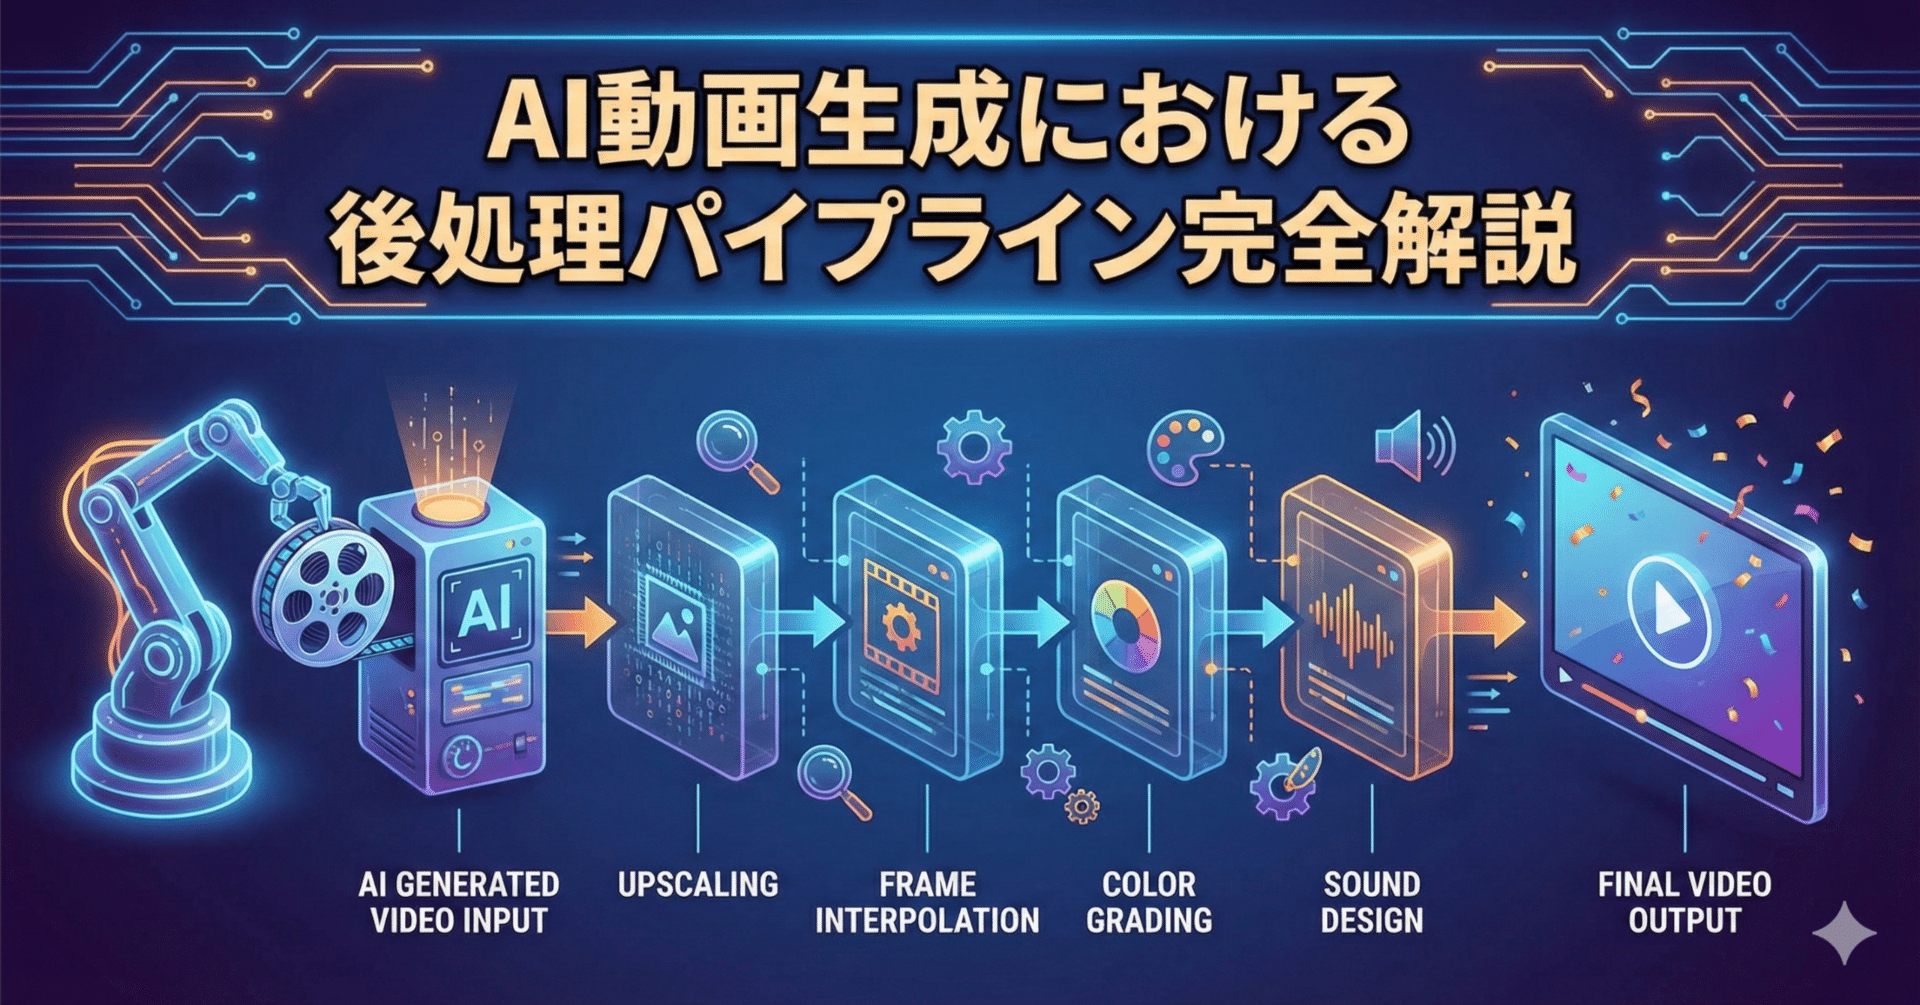
この記事はClaudeCodeにまとめさせた記事になります。当方の環境に最適化した処理となっていますので、動画のサイズ、環境依存の問題などそのまま参考にはならないかもしれませんが、一応書いてみるという話です。読んでみたら好きなことを書いていますが、基本書きっぱなしなので悪しからず。
先日から書いているWan2.2+SVI2.0PROで動画作成している話の後処理問題の話です。
はじめに
AI生成動画の品質を左右する重要な工程が「後処理」です。本記事では、WAN(Stable Video Intelligence)動画生成システムにおける後処理パイプラインの全体像から、各技術要素の詳細、最適化手法まで徹底的に解説します。
私たちのシステムでは、AIが生成した544x960ピクセル・16fpsの低解像度動画を、Instagram Reelsに投稿可能な1080x1920ピクセル・60fpsの高品質動画へと変換しています。この過程で、解像度を2倍にアップスケールし、フレームレートを約4倍に補間し、最終的にH.264形式でエンコードします。
処理時間は1本あたり約9分30秒。この速度を実現するため、TensorRTによるGPU最適化、CUDA Graphによる高速化、中間ファイル完全廃止など、多数の最適化技術を投入しています。
システム概要と目的
後処理パイプラインの目的は明確です。AI生成した動画を、SNSプラットフォームで視聴に耐えうる品質に引き上げること。具体的には以下の変換を行います。
入力仕様は544x960ピクセル、16fps、WAN 2.2ネイティブ出力です。出力仕様は1080x1920ピクセル、60fps、H.264 NVENC、Instagram Reels・YouTube Shortsに完全対応した形式となります。
この変換を実現するため、3つの主要技術を組み合わせています。Real-ESRGANによる超解像アップスケール、RIFEとFILMによる2段階フレーム補間、そしてNVENCによる高速エンコードです。
全体アーキテクチャ
後処理パイプラインは、完全にGPUメモリ上で動作するゼロコピー設計を採用しています。従来のような中間PNGファイルへの書き出しと読み込みを完全に廃止し、全処理をGPUテンソルのストリームとして扱います。
処理の流れは大きく5つのステージに分かれます。第1ステージではffmpegがrawvideoパイプで動画をデコードし、同時に544x960から540x960へクロップします。第2ステージでReal-ESRGAN TensorRTが540x960を1080x1920へアップスケールします。第3ステージでRIFE TensorRTが16fpsを32fpsへ2倍補間します。第4ステージでFILM V6 CUDA Graphが32fpsを64fpsへさらに2倍補間します。最終第5ステージでNVENCが64fpsを60fpsへ間引きながらH.264エンコードします。
この5ステージ全てがGPUメモリ上で連続的に実行され、ディスクI/Oは入力動画の読み込みと最終出力の書き出しのみとなります。
処理フロー詳細解説
ステージ1:動画デコードとクロップ
最初のステージでは、ffmpegが入力動画をデコードし、rawvideoパイプで次のステージに渡します。同時にクロップ処理も行います。
WAN 2.2が出力する544x960ピクセルの動画は、左右に2ピクセルずつ不要な領域があります。これをクロップして540x960にします。このクロップは品質向上というより、後続のReal-ESRGANが扱いやすいサイズに調整する目的です。
ffmpegのrawvideoパイプは、非圧縮のRGB24形式でフレームデータを標準出力に流します。これをPythonスクリプトが標準入力から読み取り、直接numpyアレイに変換します。この方式により、PNGエンコード・デコードのオーバーヘッドを完全に排除できます。
実装上のポイントとして、パイプからの読み取りは別スレッドで非同期に行います。GPUがフレーム処理している間に、次のフレームを先読みしておくことで、GPU稼働率を最大化します。
ステージ2:Real-ESRGAN超解像アップスケール
第2ステージでは、Real-ESRGANが540x960を1080x1920へ2倍にアップスケールします。ここで使用するのはRRDB(Residual in Residual Dense Block)アーキテクチャを持つx4plusモデルです。
通常、Real-ESRGANは4倍アップスケールを行いますが、私たちは2倍が必要なため、内部で4倍にアップスケールした後、バイリニア補間で2倍にダウンサンプリングします。この方式により、単純な2倍補間よりも高品質な結果が得られます。
TensorRT最適化が性能の鍵です。PyTorchモデルをTensorRT engineに変換し、静的な入力サイズ(336x336タイル)に最適化します。タイル処理は3行2列の6タイルで行い、タイルサイズは320ピクセル、パディングは8ピクセルです。全タイルを336x336に揃えることで、TensorRTの最適化が最大限に働きます。
バッチ処理の工夫として、6つのタイルを1回のTensorRT実行でまとめて処理します。従来の1タイルずつ処理する方式と比べ、GPU利用効率が大幅に向上し、処理速度が84%向上しました。
処理されたタイルは、オーバーラップ領域をブレンドして1枚のフレームに再構成されます。このブレンド処理もGPU上で行い、CPUへの転送は一切発生しません。
ステージ3:RIFE フレーム補間(第1段階)
第3ステージでは、RIFEが16fpsを32fpsへ2倍に補間します。RIFEはReal-Time Intermediate Flow Estimationの略で、光学フローベースのフレーム補間手法です。
RIFEの動作原理を簡単に説明します。連続する2フレーム(フレームAとフレームB)から、中間フレームを生成します。まず、双方向の光学フローを推定します。次に、推定したフローに基づいて両フレームをワープ(変形)します。最後に、ワープした2つの画像を適切にブレンドして中間フレームを生成します。
私たちはRIFE v4.25を使用しています。TensorRT変換により、PyTorchよりも約37%高速化されています。エンジンファイルは1080x1920の固定サイズに最適化されており、実行時のオーバーヘッドが最小です。
GPUテンソル直接I/Oにより、CPU-GPU間のデータ転送を完全に排除しています。入力フレーム2枚と出力フレーム1枚、全てGPUメモリ上のtorch.Tensorとして扱います。numpy変換やCPU経由の処理は一切ありません。
16fpsから32fpsへの変換では、元の16フレームに対して15枚の中間フレームを生成します。つまり、1秒間に15回RIFEを実行することになります。
ステージ4:FILM フレーム補間(第2段階)
第4ステージでは、FILM V6が32fpsを64fpsへさらに2倍に補間します。FILMはFrame Interpolation for Large Motionの略で、大きな動きにも対応できるフレーム補間手法です。
FILM V6は私たちが独自に最適化したバージョンです。PyTorchネイティブ実装をベースに、Tritonカーネルによる高精度ワープ処理、手動CUDA Graph化による実行オーバーヘッド削減を実現しています。
特に重要なのがTritonワープカーネルです。FILM V4ではワープ処理にBFloat16を使用していましたが、精度不足により黒いシミが発生する問題がありました。V6ではTritonでFP32ワープカーネルを実装し、精度を70倍改善しました。これにより黒いシミ問題を完全に解消しています。
CUDA Graphは、一連のGPU操作を事前に記録し、実行時にまとめて投入する最適化技術です。通常、PyTorchは各操作ごとにCPU-GPU間で同期が発生しますが、CUDA Graphを使うとこのオーバーヘッドが消えます。FILM V6では手動でCUDA Graphをキャプチャし、実行時に高速再生します。
V4と比較して、V6は55%高速化されています。処理速度は2.67 iterations/secondで、これは1フレームペアの処理に約0.37秒かかる計算です。
ステージ5:NVENCエンコード
最終ステージでは、NVIDIAのハードウェアエンコーダNVENCがH.264形式でエンコードします。64fpsを60fpsに間引きながら、同時にエンコードを行います。
間引き処理は単純です。64フレーム中、均等に4フレームをスキップして60フレームにします。具体的には、16フレームごとに1フレームスキップするパターンを繰り返します。
NVENCはGPU内蔵のハードウェアエンコーダで、CPUをほとんど使わずに高速エンコードできます。H.264のプロファイルはHigh、ビットレートは可変(VBR)、品質は高品質プリセットを使用します。
エンコード設定の詳細として、GOP(Group of Pictures)は30フレーム、Bフレームは2枚、参照フレームは3枚です。これらのパラメータは、Instagram ReelsとYouTube Shortsの推奨設定に基づいています。
ffmpegとNVENCの連携では、rawvideoパイプから受け取ったフレームをそのままNVENCに渡します。この時もディスクI/Oは発生せず、全てメモリ内で完結します。
使用技術の詳細
Real-ESRGAN:超解像技術の核心
Real-ESRGANは、Enhanced Super-Resolution Generative Adversarial Networksの略です。GANベースの超解像手法で、低解像度画像から高解像度画像を生成します。
RRDBアーキテクチャは、Residual in Residual Dense Blockの略で、非常に深いネットワークを安定して学習できる構造です。Dense connectionにより勾配が流れやすく、Residual learningにより学習が安定します。
x4plusモデルは、4倍アップスケール用に学習されたモデルです。Compact版(高速)とx4plus版(高品質)がありますが、私たちはバランスを考慮してx4plus + final_scale=2の組み合わせを採用しています。
TensorRT最適化の効果は絶大です。PyTorch実装と比較して、約2-3倍高速化されます。特に静的な入力サイズに最適化することで、ランタイムオーバーヘッドが最小化されます。
RIFE:光学フローベース補間
RIFEの最大の特徴は、リアルタイム性と品質の両立です。v4.25は最新バージョンで、従来版よりも精度が向上しています。
光学フロー推定では、IFNetというネットワークが双方向のフローを推定します。このフローは、ピクセルレベルでの動きベクトルを表現します。
ワープ処理では、推定したフローに基づいて元のフレームを変形します。PyTorchのgrid_sample関数を使用し、サブピクセル精度で補間します。
ブレンディングでは、2つのワープされたフレームを適切な重みで混ぜ合わせます。この重みもネットワークが学習しており、オクルージョン(隠れ)などの難しい状況でも自然な結果が得られます。
FILM:大きな動きへの対応
FILMの強みは、大きな動きに対する頑健性です。従来の光学フローベースの手法は、フレーム間の動きが大きいと失敗しやすいですが、FILMはピラミッド構造により大きな動きにも対応できます。
FILMのアーキテクチャは、Feature Pyramid Networkをベースにしています。複数のスケールで特徴を抽出し、粗いスケールから細かいスケールへと順に処理します。
Tritonカーネル最適化では、ワープ処理を高精度FP32で実装しています。NVIDIAのTritonコンパイラを使用し、CUDAカーネルを効率的に生成します。これによりBFloat16の精度問題を解決しています。
CUDA Graphの効果は、CPU-GPUオーバーヘッドの削減です。通常のPyTorch実行では、各操作ごとにPythonインタープリタとCUDAドライバ間で通信が発生しますが、CUDA Graphではこれが1回のカーネル起動にまとまります。
TensorRT:推論最適化の決定版
TensorRTはNVIDIAが提供する深層学習推論エンジンです。PyTorchやONNXモデルをTensorRT engineに変換することで、大幅な高速化が可能になります。
最適化の仕組みとして、レイヤー融合があります。複数の演算を1つのCUDAカーネルにまとめることで、メモリアクセスとカーネル起動オーバーヘッドを削減します。
精度とメモリの最適化では、FP16やINT8といった低精度演算を活用します。私たちのシステムではFP16を使用し、精度を保ちながら高速化しています。
カーネル自動調整により、実行環境に最適なCUDAカーネルを自動選択します。これによりGPUアーキテクチャごとに最高の性能を引き出せます。
性能最適化のポイント
ゼロコピー設計
最大の最適化は中間ファイルの完全廃止です。従来のパイプラインでは、各ステージ間でPNGファイルに書き出し、次のステージで読み込んでいました。この往復だけで動画1本あたり約25秒かかっていました。
ゼロコピー設計では、全てのデータがGPUメモリ上のtorch.Tensorとして扱われます。ステージ間のデータ受け渡しは、単なるポインタの引き渡しです。メモリコピーすら発生しません。
パイプライン処理により、デコード・処理・エンコードが並行して動作します。ffmpegがフレームをデコードしている間に、GPUが前のフレームを処理し、NVENCが更に前のフレームをエンコードします。この3段パイプラインにより、GPUとエンコーダの稼働率が最大化されます。
モデル常駐戦略
従来のバッチ処理では、動画1本ごとにモデルをロード・アンロードしていました。特にFILMのwarmup処理に約90秒かかるため、これが大きなボトルネックでした。
モデル常駐により、一度ロードしたモデルをメモリに保持し続けます。2本目以降の動画では、warmupをスキップして即座に処理を開始できます。
メモリ管理として、各動画処理後にtorch.cuda.empty_cache()を呼び出します。これによりメモリ断片化を防ぎ、OOM(Out of Memory)エラーを回避します。
RTX 5060 Tiの16GB VRAMで、モデル常駐は約1GB、フレームバッファは最大600MB、合計でも2GB未満です。十分な余裕があり、安定動作します。
バッチ処理とタイル最適化
Real-ESRGANのタイル処理では、全タイルのサイズを336x336に統一しています。可変サイズタイルではTensorRTの最適化が効かないため、固定サイズにゼロパディングします。
バッチサイズ6により、6タイルを1回のTensorRT実行で処理します。これによりGPU利用効率が向上し、従来の1タイルずつ処理と比べて84%高速化しました。
メモリアクセスパターンの最適化として、タイルの読み書きを連続メモリアクセスにします。PyTorchのtensor.contiguous()を適切に使用し、キャッシュヒット率を向上させます。
非同期処理とストリーミング
ffmpegパイプの非同期読み取りにより、GPUがフレーム処理している間に次のフレームを先読みします。Pythonのthreadingモジュールとqueueを使用し、プロデューサー・コンシューマーパターンを実装しています。
CUDA streamの活用により、データ転送とカーネル実行を並行化します。RIFEとFILMでは、明示的にCUDA streamを制御し、GPU内部でのパイプライン処理を実現しています。
スライディングウィンドウ方式では、16フレームを処理単位とします。メモリ使用量を一定に保ちながら、任意の長さの動画を処理できます。
処理時間の内訳
1本の動画(5セグメント、81フレーム、約5秒×5)を処理する際の時間内訳を示します。
Real-ESRGANが約35秒で全体の37%を占めます。1080x1920への高解像度化は計算コストが高く、最も時間がかかるステージです。
RIFE TRTは約25秒で26%です。16fpsから32fpsへの変換で、81フレームに対して約80回の補間処理を実行します。
FILM V6は約60秒で最大の40%です。32fpsから64fpsへの変換で、さらに160回の補間処理を実行します。フレーム数が多いため、総処理時間も増えます。
PNG I/Oの削減により約25秒短縮しました。従来パイプラインでは、各ステージ間でPNG書き出し・読み込みが発生していましたが、これを完全に排除しています。
NVENCエンコードは約10秒で11%です。ハードウェアエンコーダのため非常に高速で、ボトルネックにはなりません。
合計で約9分30秒、570秒程度で1本の動画を処理できます。
最適化の限界:FP8量子化検証
後処理パイプラインのさらなる高速化を目指して、TensorRT FP8量子化を検証しました。理論上はFP16と比較して2倍の高速化が期待されましたが、結果は期待に反するものでした。この検証から得られた教訓は、最適化には技術的な限界があり、全ての手法が全てのワークロードに適用できるわけではないという現実です。
FP8量子化とは
FP8(8ビット浮動小数点)は、FP16(16ビット浮動小数点)と比較してメモリ使用量が半分、演算速度が理論上2倍となる量子化手法です。Blackwell世代GPU(RTX 5060 Ti)は第5世代Tensor Coreを搭載し、FP8演算性能が94.81 TFLOPSに達します。スパース演算を含めると189.63 TFLOPSという高性能です。
LLM(大規模言語モデル)推論では、FP8量子化による明確な成功例が報告されています。Mistral 7BをFP8量子化した場合、レイテンシが8.5%減少し、スループットが33%向上しました。Stable Diffusionでも、RTX 6000 Ada GPUでFP16と比較してFP8が1.95倍の高速化を達成しています。
私たちの検証結果
Real-ESRGANとRIFEのTensorRTエンジンをFP8量子化してビルドしました。しかし、実際に使用しようとすると、以下のエラーが発生しました。
エラー内容は「The engine plan file is not compatible with this version of TensorRT, expecting library version 10.15.1.29 got ...0, please rebuild」というものでした。これは、エンジンファイルが古いTensorRTバージョンでビルドされたため、現在のTensorRT 10.15.1.29と互換性がないことを示しています。
FP8で高速化しない本質的理由
仮にエンジンを再ビルドして互換性問題を解決したとしても、Real-ESRGANとRIFEではFP8による大幅な高速化は期待できません。この判断には明確な技術的根拠があります。
第一の理由は、メモリバンド幅ボトルネックです。Real-ESRGANは1080x1920という高解像度の画像を扱います。入力540x960から出力1080x1920まで、大量のピクセルデータをメモリから読み書きします。この場合、演算よりもメモリアクセスが支配的です。RIFEも光学フロー推定とワープ処理で不規則なメモリアクセスパターンを持ち、メモリバンド幅に強く依存します。
RTX 5060 Tiのメモリバンド幅は448 GB/sです。一方、FP8演算性能は189 TFLOPSに達します。この不均衡により、メモリバンド幅がボトルネックとなり、FP8の高速演算能力を活かせません。演算精度を下げても、メモリアクセス量が変わらなければ、全体の処理時間は改善されないのです。
第二の理由は、最適化カーネルの不足です。TensorRTがFP16用の融合カーネルを提供している一方、FP8では融合カーネルが存在せず、複数の小さな行列乗算に分解されるケースがあります。この場合、量子化・逆量子化のオーバーヘッドにより、むしろ遅くなる可能性があります。
第三の理由は、ワークロード特性の不一致です。FP8が効果を発揮するのは、主に行列乗算が支配的なワークロード(Transformer、LLM)です。一方、Real-ESRGANのRRDBアーキテクチャや、RIFEの複雑なフロー推定ネットワークは、畳み込み層や複雑な制御フローを持ちます。これらのオペレーターに対するFP8カーネルの最適化は、LLMほど成熟していません。
LLMとの違い
なぜLLMではFP8が効果的で、画像処理では効果が薄いのでしょうか。LLMは行列乗算の繰り返しという単純なパターンで、計算律速のワークロードです。データサイズは大きいですが、演算量がさらに大きいため、演算精度を下げる効果が明確に現れます。
一方、画像処理は畳み込み、ワープ、ブレンドなど多様なオペレーターを持ち、メモリアクセスパターンが複雑です。特に高解像度画像では、ピクセルデータの読み書きが支配的になり、演算最適化の効果が限定的になります。
現実的な最適化戦略
この検証から得られた教訓は、「理論的に可能」と「実際に効果がある」は別物だということです。ハードウェアが対応していても、ワークロードの特性によっては効果が出ません。
FP8よりも効果的な最適化として、以下を検討しています。FILM TensorRT化は、現在PyTorchで動作しているFILMをTensorRT化することで、約30秒の短縮が見込めます。これはFP8よりも大きなインパクトがあります。モデル軽量化では、MobileNet系の軽量アーキテクチャへの移行や、知識蒸留による小型モデルの作成を検討します。マルチGPU並列化では、複数動画を並列処理することで、全体のスループットを向上させます。
最適化は闇雲に新しい技術を試すのではなく、ボトルネックを正確に特定し、そこに効く手法を選ぶことが重要です。私たちの場合、FP8よりも先にTensorRT化の範囲拡大と、パイプライン並列度の向上に注力すべきだという結論に至りました。
今後の最適化方向
最適化には優先順位があります。前述のFP8検証で学んだように、理論的に可能な手法が必ずしも実効果を生むとは限りません。ここでは、ボトルネック分析に基づいた現実的な最適化方向を示します。
FILM TensorRT化
最も効果が期待できるのがFILM TensorRT化です。現在、FILMはPyTorch + CUDA Graphで動作しており、全体の40%を占める最大のボトルネックです。TensorRT化により約30秒の短縮が見込めます。
技術的な課題は、FILMの動的な処理フローをTensorRTで表現することです。ピラミッド構造の各レベルで異なるサイズのテンソルを扱うため、静的グラフ化が困難です。しかし、入力サイズを固定すれば、ピラミッドの各レベルサイズも固定できます。この制約下でTensorRT化する手法を検証中です。
もう一つの課題は、Triton FP32ワープカーネルの互換性です。現在のTritonカーネルをCUDAカーネルに移植し、TensorRTプラグインとして統合する必要があります。これには専用カーネル開発の知識が必要ですが、成功すれば大きな効果が得られます。
マルチGPU並列化
2番目に効果的なのがマルチGPU並列化です。現在は1GPUで1動画を順次処理していますが、複数のGPUで並列処理すれば、スループットを倍増できます。
実装方針として、各GPUに独立したプロセスを割り当て、動画キューから処理を分散します。GPU間でのデータ転送は発生しないため、スケーリング効率は理想的です。
課題はメモリ管理です。各GPUがモデルを常駐させるため、複数GPU環境では総VRAMが重要になります。RTX 5060 TiのVRAMは16GBで、1GPU当たりのモデル常駐は約1GBのため、余裕があります。
カスタムCUDAカーネル
最も高度だが効果が限定的なのが、カスタムCUDAカーネルです。特にタイルブレンディングやフレーム補間の一部処理を専用カーネルで実装すれば、数%の効率化が見込めます。
ただし、開発コストが高く、保守性が低下するため、他の最適化を優先すべきです。既存のTensorRTやCUDA Graphで十分な性能が出ている現状では、カスタムカーネルの優先度は低いと判断しています。
モデル軽量化
根本的なアプローチとして、モデル自体の軽量化があります。Real-ESRGANをMobileNet系のアーキテクチャに置き換えたり、知識蒸留で小型化したりする手法です。
品質とのトレードオフが課題です。現在の品質水準を維持しながら、どこまで軽量化できるかは未知数です。まずは小規模な実験で品質影響を評価し、許容範囲内であれば本格導入を検討します。
まとめ
AI動画生成における後処理は、単なる解像度変換やフレーム補間ではありません。複数の最先端技術を組み合わせ、GPUの性能を最大限に引き出し、実用的な処理時間を実現する総合的なシステムです。
私たちのパイプラインは、TensorRTによる深層学習推論の最適化、CUDA Graphによる実行オーバーヘッドの削減、ゼロコピー設計による中間ファイル廃止、モデル常駐による初期化コストの排除など、多数の最適化技術を投入しています。
その結果、1本あたり約9分30秒という実用的な処理時間を達成しました。これにより、日々のコンテンツ制作ワークフローに組み込むことが可能になっています。
今後もFP8量子化やFILM TensorRT化など、さらなる高速化に取り組んでいきます。AI動画生成技術の進化とともに、後処理技術も進化し続けます。
この記事が、AI動画生成に取り組む方々の参考になれば幸いです。技術的な質問や議論は、ぜひコミュニティで共有していきましょう。
SwitchBot公式ページ
クーポン「AF-4903」で5%引き(アフィリエイトクーポンになりますのでご協力お願いします)
割引の詳しい仕組みに関してはこちらのページを参照ください。